Détection de discours haineux en français
Un classifieur CamemBERT pour repérer les messages haineux en ligne, et surtout une évaluation honnête : audit du corpus, validation séparée, seuil de décision choisi sur des données dédiées.
- Période
- 2026
- Type
- Projet personnel
- Modèle
- CamemBERT (camembert-base)
- Données
- FrenchHateSpeech
Superset
Le problème
Détecter automatiquement les messages haineux pour aider la modération. Deux pièges classiques : un corpus déséquilibré, où un modèle naïf apprend à toujours répondre « non haineux », et une évaluation trop optimiste.
Ce qu'un audit des données a révélé
Le jeu de données compte 42 660 lignes, mais seulement 7 499 textes distincts : plus de 80 % des lignes sont des doublons. Dans une première version, les mêmes phrases se retrouvaient à la fois en entraînement et en test, et les résultats n'étaient pas fiables (précision de 0,20 sur la classe « haineux »). J'ai donc tout repris.
La démarche (v2)
- Trois jeux distincts : 5 249 exemples d'entraînement, 1 125 de validation, 1 125 de test. Le test n'est utilisé qu'une fois, à la fin.
- Perte pondérée par l'inverse de la fréquence des classes, et meilleur modèle choisi sur le F1 « haineux » en validation.
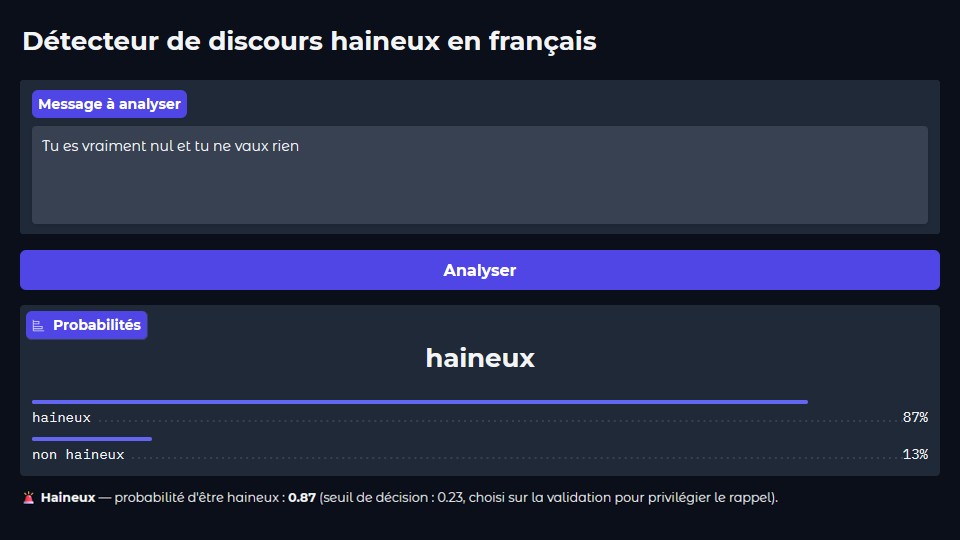
- Seuil de décision ajusté : 0,23 plutôt que 0,5. En modération, rater un message haineux coûte plus cher qu'une fausse alerte.
Résultats sur le test
Sur 1 125 messages jamais vus : 489 messages haineux détectés, 66 manqués, 129 fausses alertes.
Limites
- Les menaces implicites échappent encore au modèle : « Je vais te retrouver et tu vas le regretter » est classé non haineux. Il s'appuie surtout sur le vocabulaire explicite.
- Certaines étiquettes du corpus sont discutables, et le corpus reste modeste après déduplication.
- C'est un outil d'aide à la modération, pas un juge : la relecture humaine reste indispensable.
Python · Transformers · CamemBERT · PyTorch · scikit-learn · Google Colab (GPU T4)